
Un RAG en producción no se parece al RAG del piloto. En el piloto respondió bien las preguntas que el equipo eligió; en operación recibe las que nadie anticipó, sobre documentos que cambian cada semana. Ese salto es justo lo que el piloto no mide. En este artículo reviso los siete puntos de falla que documentó un estudio sobre tres sistemas reales, en qué etapa del pipeline ocurre cada uno y qué instrumentación necesita su equipo para detectarlos antes que el usuario.
Lo esencial
- Un RAG en producción solo se puede validar operando: la evaluación offline necesita pares pregunta-respuesta que casi nunca existen al inicio.
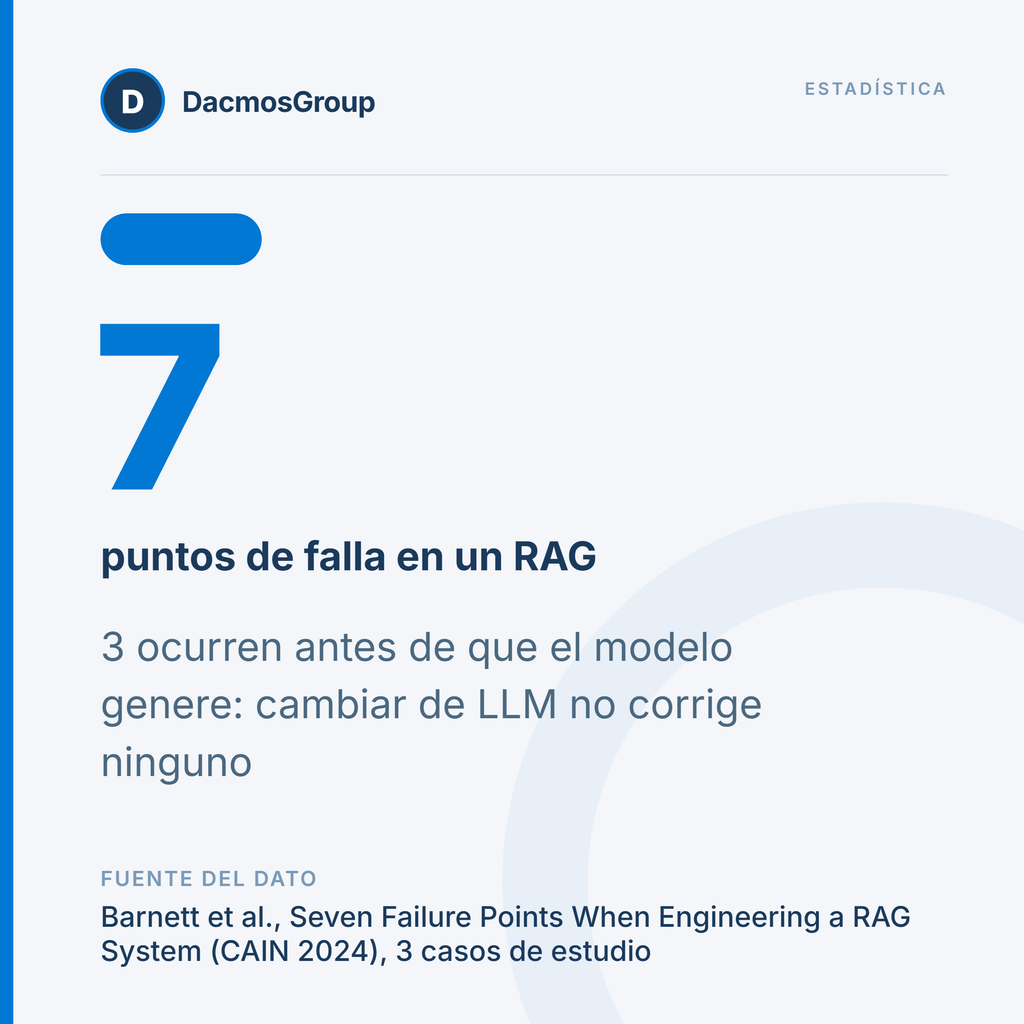
- De los siete puntos de falla documentados, tres ocurren antes de que el modelo genere una sola palabra.
- La salida no es un mejor modelo, sino un pipeline configurable con métricas separadas para retrieval y generación.
Por qué un RAG en producción no se valida en el piloto
La referencia técnica más citada sobre este problema es el paper Seven Failure Points When Engineering a Retrieval Augmented Generation System, de Barnett y colegas, presentado en CAIN 2024. Analiza tres sistemas en operación: Cognitive Reviewer, para investigación; AI Tutor, para educación, y un experimento biomédico sobre el dataset BioASQ.
Sus dos conclusiones son incómodas para cualquier plan de proyecto. La validación de un sistema RAG solo es factible durante la operación. Y su robustez evoluciona con el uso: no se diseña completa al inicio.
La razón es mecánica. Evaluar offline exige un set de preguntas con respuestas etiquetadas, y ese set rara vez existe cuando arranca el proyecto. El equipo prueba con las preguntas que se le ocurren, que son las que el sistema ya sabe responder.
Los siete puntos de falla de un RAG en producción
El paper clasifica las fallas por etapa. La tabla sirve como checklist cuando un usuario reporta una respuesta mala.
| Etapa | Falla | Qué la delata |
|---|---|---|
| Corpus | 1. Contenido ausente | Responde con seguridad algo que no está en los documentos |
| Retrieval | 2. Documento fuera del top-K | La respuesta existe, pero quedó por debajo del corte |
| Consolidación | 3. Fuera del contexto | Se recuperó, pero se descartó al armar el prompt |
| Generación | 4. No extraído | Estaba en el contexto y el modelo no lo usó |
| Generación | 5. Formato incorrecto | Ignora la instrucción de tabla, lista o estructura |
| Generación | 6. Especificidad incorrecta | Demasiado general o demasiado detallada para la pregunta |
| Generación | 7. Incompleta | Correcta, pero omite información que tenía disponible |
Tres de las siete fallas ocurren antes de que el modelo genere. Cambiar de LLM no corrige ninguna de ellas. Es el primer filtro que aplico cuando me dicen que “el modelo alucina”: antes de tocar el prompt, reviso si la respuesta correcta llegó al contexto.
Si este análisis le resulta útil, recíbalo cada semana: 👉 Suscríbase al newsletter de DacmosGroup
Qué instrumentar en un RAG en producción desde el día uno
1. Un set de evaluación que crece con el uso
Registre las consultas reales con su contexto y respuesta, y etiquete una muestra cada semana. Ese set es el que el paper dice que falta al inicio: no se compra, se acumula operando.
2. Métricas separadas para retrieval y generación
Recall@k y precision@k le dicen si el documento correcto llegó. Groundedness y completitud le dicen qué hizo el modelo con él. Si mide solo la respuesta final, no sabrá en cuál de las siete fallas está.
3. Índice y embeddings versionados
Guarde el modelo de embedding y su versión como metadato de cada vector, y no mezcle versiones en la misma colección. Sin eso, un cambio de modelo degrada el retrieval de un RAG en producción en silencio.
4. Búsqueda híbrida y metadatos como base
Combinar búsqueda léxica (BM25) con vectores densos, más un reranker, es hoy la línea base razonable, no una optimización tardía. El propio paper reporta que agregar metadatos como nombre de archivo y número de chunk al contexto mejoró las respuestas de AI Tutor.
Punto clave
Un RAG en producción sin métricas separadas de retrieval y generación no se puede diagnosticar. Solo se puede culpar al modelo.
Un pipeline que se pueda recalibrar
La otra lección es que la calibración no termina. Tamaño de chunk, modelo de embedding, estrategia de retrieval, consolidación, ventana de contexto y prompt son parámetros que van a cambiar con las consultas reales. En un RAG en producción, un pipeline cableado a mano obliga a reescribir código para cada ajuste.
Un RAG en producción no se aprueba una vez. Se vuelve a validar cada vez que cambian los documentos, las preguntas o el modelo.
Esta semana, Alejandro planteó que la IA agéntica necesita un interruptor de apagado que alguien sepa usar. El equivalente para un RAG en producción es la instrumentación: sin ella, nadie sabe cuándo empezó a fallar ni en qué etapa.
Preguntas frecuentes
¿Cuándo está listo un RAG en producción para salir del piloto?
Cuando tiene registro de consultas reales, métricas separadas de retrieval y generación y un proceso para recalibrar. La precisión del piloto no basta: se midió con preguntas que el equipo ya conocía.
¿Cambiar a un modelo más grande resuelve las respuestas malas?
Solo si la falla es de generación. Si el documento correcto no llegó al contexto, un modelo mejor responde con la misma falta de información.
Operarlo es parte del diseño
El error de fondo es tratar el piloto como la fase de construcción y la producción como la fase de mantenimiento. En un RAG en producción la relación es inversa: el piloto valida la arquitectura y la operación termina de construir el sistema. Presupuestar esa segunda fase separa un RAG que mejora de uno que se abandona.
¿Cuál de los siete puntos de falla le costó más detectar en su último proyecto RAG?
Y si hoy mide calidad, ¿separa retrieval de generación o evalúa solo la respuesta final? Cuénteme en los comentarios.
Si quiere recibir análisis técnicos como este cada semana, suscríbase al newsletter de DacmosGroup. Y si su RAG trabaja con documentos en español, revise por qué el modelo base también cambia el costo y la calidad del retrieval.